TL;DR
- Trouver des failles dans l’open source en 2026, “grâce” aux LLM : facile, OUI
- Être le premier à les remonter : possible, MAIS
Trouver des failles est devenu banal. Le vrai défi, c’est d’être le premier, et de survivre au triage. C’est de ça que parle le reste de l’article.
Pourquoi faire ça, au départ ?
La cybersécurité, ça me passionne depuis… bah, depuis toujours. Mon deuxième programme d’enfant était un VB 3.0 à la con, un faux virus qui avait pour seul boulot de remplir le dossier Démarrage de Windows 95/98 de milliers de commandes netsend auto-exécutables (si vous ne savez pas ce que c’était, allez jeter un œil !).
Mais je n’en ai jamais fait mon métier, même si l’idée m’est venue à plusieurs reprises. Ces derniers mois, j’ai collaboré plus étroitement que d’habitude avec mes collègues de l’équipe cybersécurité, et j’ai fini par me lancer : je voulais voir ce que je pouvais faire avec les LLM dans ce domaine.
Disclaimer : je ne suis PAS spécialiste en cybersécurité, pas le moins du monde. Si vous ne me connaissez pas, je ne suis qu’un platform engineer qui s’y connaît en Kubernetes, virtualisation et observabilité. Je code de manière correte en golang et en python.
Quel est le but, au juste ?
Ces deux derniers mois, je me suis mis à traquer (sur mon temps libre) des vulnérabilités dans des logiciels open source populaires que j’utilise au quotidien dans mon travail. Certains ont un programme de bug bounty, d’autres acceptent les GitHub Security Advisories. D’autres ne répondent tout simplement pas.
Pourquoi l’open source ? Bah déjà, le fait que le code soit ouvert me permet de vérifier les choses quand le LLM pense que quelque chose cloche, et de me forger ma propre opinion. L’inconvénient, honnêtement, c’est que les LLM sont aussi la raison pour laquelle l’open source se noie sous les rapports de sécurité depuis environ un an.
Mais surtout : je travaille avec ces outils tous les jours, je sais donc COMMENT ils devraient fonctionner, et ce qui N’EST PAS normal. On reviendra là-dessus aussi.
Une chose avant de commencer : tout ce qui est décrit ci-dessous a été fait sur ma propre infrastructure : clusters jetables, installations locales, VM de test. Chaque programme de bug bounty a ses règles du jeu : pas de scan d’instances tierces, pas de toucher aux données des autres, pas de déni de service sur une infra partagée. Lisez-les. Si une de vos découvertes nécessite de les enfreindre pour être prouvé, c’est que vous vous y prenez mal.
Ok ok, assez d’introduction : les LLM peuvent-ils trouver des failles sans expérience en cybersécurité ?
Réponse courte : oui. La vraie question, c’est de savoir si ça vaut le coup, et ça dépend surtout de si vous voulez être le premier ou non, et de QUAND vous commencez.
Voici mon propre retour d’expérience sur la chasse aux vulnérabilités dans l’open source. “YMMV”, comme on dit.
Vous avez déjà raté le coche
La première chose à savoir, c’est que (si vous commencez aujourd’hui) vous êtes très en retard.
C’est encore plus vrai pour les logiciels couverts par un bug bounty, parce que les chasseurs fouillaient déjà avant l’arrivée des LLM. Mais la pression sur ces projets a été multipliée par mille depuis.
Des chiffres concrets, tirés des pages publiques de deux très gros projets (stats sur 90 jours, septembre 2026), volontairement non cités (c’est bien l’écart qui compte) :
- Un programme, encore à peu près en vie : 4 193 rapports reçus, ~454 000 $ versés
- L’autre, essentiellement mort : 551 rapports reçus, 1 000 $ versés, dernier rapport traité il y a un mois
Relisez bien. Ce volume, c’est en grande partie du bruit généré par de l’IA. curl a complètement arrêté son bug bounty payant en début 2026, après l’effondrement du ratio de rapports valides. D’autres projets ont suspendu les paiements ou sont passés en accès sur invitation (Nextcloud, Grafana). Les mainteneurs se noient.
Alors si vous pensez être plus malin que tout le monde et que vous comptez vous faire de l’argent rapide avec votre compte Claude, réfléchissez-y à deux fois. Des centaines de personnes y avaient déjà pensé il y a un an, et il y en a un peu plus chaque jour. Vous êtes en concurrence avec elles, avec des professionnels aguerris, et avec des gens qui ont bien plus de ressources IA que vous.
Parlons modèles (choisissez vos armes)
J’ai d’abord essayé les options évidentes (“ça se passe mal!”) :
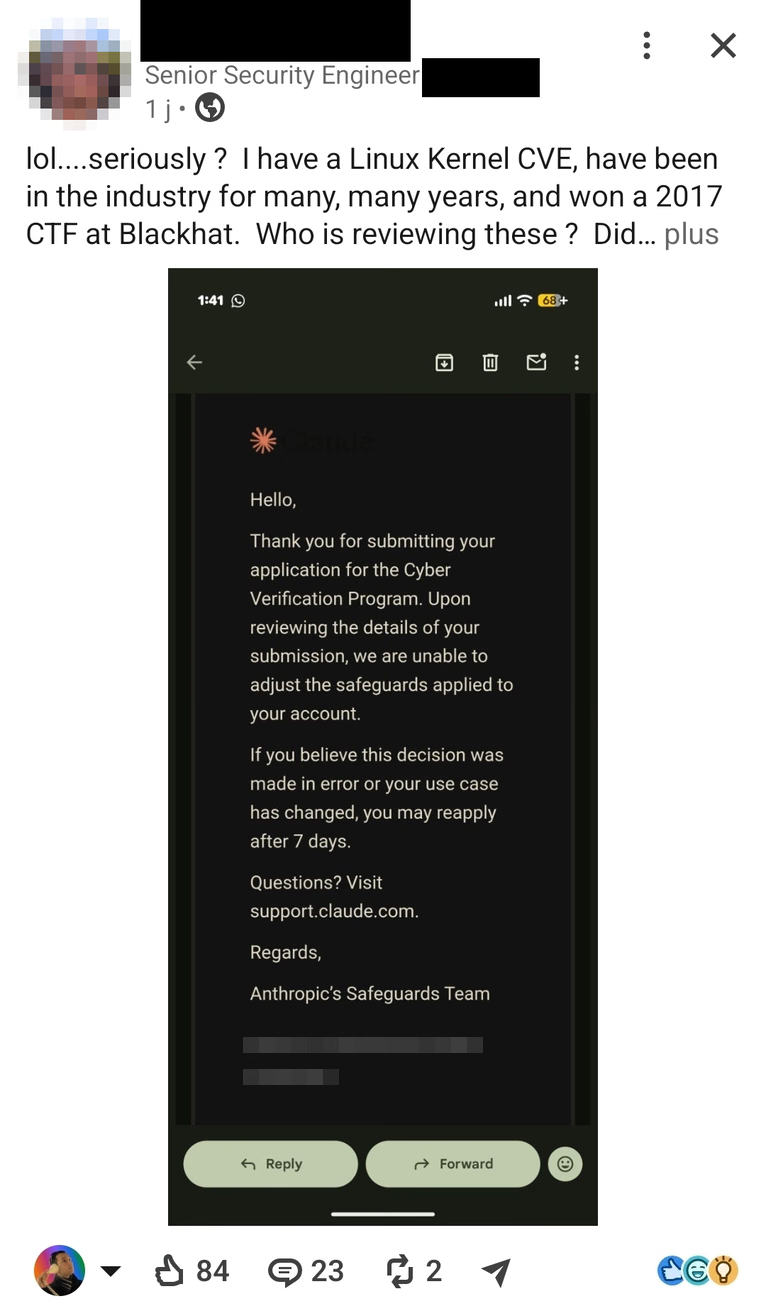
Claude : tout ce qui touche de près ou de loin à la cybersécurité est flaggé et bascule en mode fortement restreint. Au bout de quelques heures, la session est carrément gelée. La seule parade, c’est de relancer des sessions et de perdre son contexte à chaque fois - et les blocages se font plus fréquents avec le temps, même pour du travail parfaitement légitime. La voie officielle, c’est le Cyber Verification Program d’Anthropic (OpenAI a un équivalent, le Cybersecurity Grant Program), mais la validation semble arbitraire : plusieurs chercheurs en sécurité que je connais personnellement se sont fait refuser sans explication, et ils ne sont pas seuls.
Google Antigravity : ça a très bien marché pendant 2 jours, puis les blocages ont commencé. Google n’a aucun programme pour certifier les chasseurs légitimes, vous pouvez donc l’oublier. Un mois d’abonnement pour rien.
Ce qui marche : laissez tomber les grands fournisseurs américains et passez à des alternatives moins regardantes. Soit un accès par abonnement à des modèles open weights / chinois, soit des plateformes agentic avec des quotas généreux.
Et les API au token ? Très mauvaise idée pour ce genre de travail. La chasse aux failles demande un nombre absurde de tokens en lecture. Mes chiffres à moi : environ 11 milliards de tokens en 2 mois, dont la grande majorité (plus de 90%) servie depuis le cache côté fournisseur. Même avec l’une des options les moins chères au moment où j’écris (GLM 5.3 sur un broker bien connu), ça revient à environ 1 800 $. Un modèle frontier coûterait plusieurs fois ce montant. Choisir un fournisseur dont le cache est facturé moins cher aide énormément, mais vous ne voulez quand même pas de cette facture en fin de mois.
Les abonnements qui donnent accès à GLM, DeepSeek, Kimi… sont probablement de bonnes options (pas encore essayé). Ce que j’ai réellement utilisé pendant 2 mois, c’est devin.ai (l’outil agentic de Cognition, anciennement Windsurf) : leur modèle maison est compétent et, au moment où j’écris, illimité dans l’abonnement de base. Ce genre de promo va et vient, vérifiez avant de vous abonner.
Pas sponsorisé, je paie de ma poche 🥲.
Et les modèles locaux ?
L’idée est vraiment séduisante. Être autonome avec du matériel local (ou en louer) plutôt que de payer au token des tâches coûteuses, tout en échappant à la censure des fournisseurs, ça ressemble à une idée de génie (qui pense GIFI dans sa tête ?). C’est la première chose que j’ai essayée après mon “fiasco” Claude/Antigravity.
Alors… peut-on utiliser des modèles open weights locaux pour éviter de griller son quota en 20 minutes ? Avec un modèle ~30B (type Qwen, ou la meilleure variante du moment), on peut trouver quelques failles sur des gros projets anciens… mais c’est comme courir un marathon avec un sac à dos rempli de cailloux après les avoir peint (dédicasse à Vincent). C’est faisable, mais ne vous attendez pas à ce que ce soit simple ni efficace.
Si vous partez sur cette voie, le pipeline ci-dessous compte encore plus qu’avec des modèles plus “gros”.
Mon pipeline
Quel que soit le modèle, la première chose dont vous avez besoin, c’est un cadre solide. Voilà ce que j’ai fait (plutôt basique, il existe peut-être des méthodes plus efficaces, mais c’est un bon point de départ) :
- Analysez un composant de votre cible à la fois. Demandez au modèle de cartographier son fonctionnement en amont. Terminez-le complètement avant de passer au suivant.
- Une fois la cartographie faite, répartissez le travail (surtout des fichiers de code) entre des subagents, chacun focalisé sur une partie bien délimitée. Demandez-leur de chercher des anti-patterns connus dans les fonctions, des variables mal vérifiées et compagnie, et de consigner dans un fichier markdown tout ce qui leur paraît même vaguement bizarre ou dangereux, pour analyse ultérieure.
- Faites relire le travail des subagents par l’agent principal. Chaque constat part soit dans un dossier “non-security findings” (bugs trop faibles ou trop restreints pour être exploités : je m’en sers pour faire des PR d’amélioration en upstream), soit dans un dossier “security findings” pour contre-expertise.
- Une fois le scan initial terminé, demandez à l’agent principal une contre-expertise de tous les nouveaux constats sécurité validés.
Contre-expertise
C’est là que vient l’essentiel de la valeur de mes scans LLM. J’ai mis deux mois à affiner cette étape, et j’y travaille toujours.
Ma checklist actuelle :
- Chercher sur GitHub/GitLab les issues, PR et documents d’amélioration éventuels. Soumettre un problème de sécurité déjà connu, c’est évidemment une mauvaise idée.
- Regarder aussi dans la doc officielle les limitations connues, les faiblesses & compromis documentés (c’est à dire “acceptés” par les mainteneurs, donc inéligibles), les bonnes pratiques de sécurité.
- Quand vous êtes sûr à 100% qu’il n’y a ni correctif public ni rapport antérieur, demandez au modèle de reproduire sur le vrai logiciel. Selon la cible, vous voudrez peut-être des runbooks pour différentes configurations sur différentes plateformes. Cette étape est particulièrement importante avec les modèles locaux, qui sortent des rapports de vulnérabilité absolument convaincants mais qui ne marchent jamais.
- Une fois reproduite, notez-la. La plupart des bug bounties demandent un score CVSS, mais il faut aller plus loin que ça.
Concrètement, un constat dans mon pipeline, ça ressemble à ça : un subagent signale un pattern suspect dans un fichier que personne ne lit -> l’orchestrateur le déduplique face aux issues publiques et aux flux de CVE -> si ça passe, reproduction sur un cluster kind jetable ou une installation locale du vrai logiciel -> puis noté, rédigé, soumis… et ensuite, vous attendez. Le triage prend en général quelques semaines/mois. Parfois quelques jours, et dans de rares cas plusieurs années (on y reviendra, c’est généralement le signe d’un programme surchargé ou mort).
Noter à la juste valeur
Une fois que vous avez de vraies vulnérabilités, les noter avec un CVSS est une étape nécessaire. Mais le travail ne s’arrête pas là. Tout le monde qui a fait un peu de cybersécurité sait bien que le CVSS ne raconte pas toute l’histoire. Et les LLM auront tendance à surévaluer leurs propres constats.
Faites poser ces questions à l’agent pendant la contre-expertise :
- Le constat est-il réaliste ?
- Les prérequis sont-ils réalistes ?
- Existeraient-ils / arriveraient-ils dans un déploiement réel, pas seulement en théorie ?
- La configuration est-elle saine (et non un piège où l’admin de notre scénario mériterait presque d’être compromis) ?
- Un attaquant chercherait-il vraiment à exploiter ça ?
- Le constat donne-t-il plus de droits que l’attaquant n’en a déjà ?
Toutes ces réponses (ou au moins la plupart) devraient être “oui”. Sinon, ce n’est probablement pas un problème de sécurité (ou en tout cas, c’est ce que les équipes sécurité de ces projets vous diront !), quoi qu’en dise le CVSS.
Il y a évidemment des exceptions, mais pour rester simple restons dans le cas général.
Appropriez-vous le rapport
Une fois tout ça fait, prenez le temps de le relire (vous, l’humain). Selon la qualité du modèle, vous trouverez peut être le rapport ridicule :
- Lisez le rapport du LLM attentivement, comprenez-le, appropriez-vous-en !
- Si quelque chose vous paraît bizarre, challengez le LLM
- Si une affirmation est exagérée, challengez le LLM
C’est là qu’un bagage en cybersécurité ou une connaissance fine de l’outil que vous auditez devient vraiment utile. Ça vous évitera de vous ridiculiser (l’humain, le LLM, lui, s’en fout).
Ne faites pas partie du problème
Prenons le taureau par les cornes : je viens de vous dire que les mainteneurs se noient sous les rapports générés par l’IA, et j’en ai envoyé plus de 30 moi-même. Oui, il y a un léger problème de cohérence. Voici ce que j’essaie de faire autrement :
- Rien n’est soumis sans avoir été reproduit sur le vrai logiciel et/ou un vrai cluster
- Chaque rapport est lu, compris et assumé par moi avant de partir. Si je ne peux pas l’expliquer aux mainteneurs sans le LLM, il ne part pas
- Les constats à faible sévérité ou limite ne passent pas par les canaux sécurité : ils finissent en issues publiques ou en PR en upstream
- Les notes sont contestées : pas de CVSS gonflé par le LLM
- Sur les petits projets, les rapports partent un par un, en attendant le triage avant d’en envoyer d’autres
Les doublons arrivent quand même (9 pour l’instant), mais un doublon de vraie vulnérabilité reproduite coûte quelques minutes au triage sur des plateformes de bug bounty. Un rapport halluciné lui coûte potentiellement des heures, et beaucoup de la patience du maintainer.
Gardez une trace de tout
Ça, je l’avais pas vu venir.
Très très (très) vite, on est soi même ensevelli sous les reports. Après une trentaine de constats et une dizaine de rapports envoyés, je ne savais plus où j’en étais, honnêtement. Quel constat avait été reproduit ? Lequel avait déjà été soumis, et dans quel programme ? Quel rapport m’attendait, et lequel attendait les mainteneurs ? Un dossier de fichiers markdown ne passe pas à l’échelle, et les immenses tables markdown entretenues par le LLM sont vite devenues ingérables aussi.
Du coup, j’ai fini par faire “Clauder” mon tableau de bord de suivi (oui, l’ironie : Claude code avec plaisir une UI pour chasser des failles, il veut juste pas faire la chasse lui-même). La source de vérité est désormais une base JSON, que le LLM met à jour via des scripts (jamais en éditant le fichier à la main). À chaque commit, un tableau kanban HTML statique est régénéré à partir de celle-ci, en suivant chaque constat tout au long de son cycle de vie.
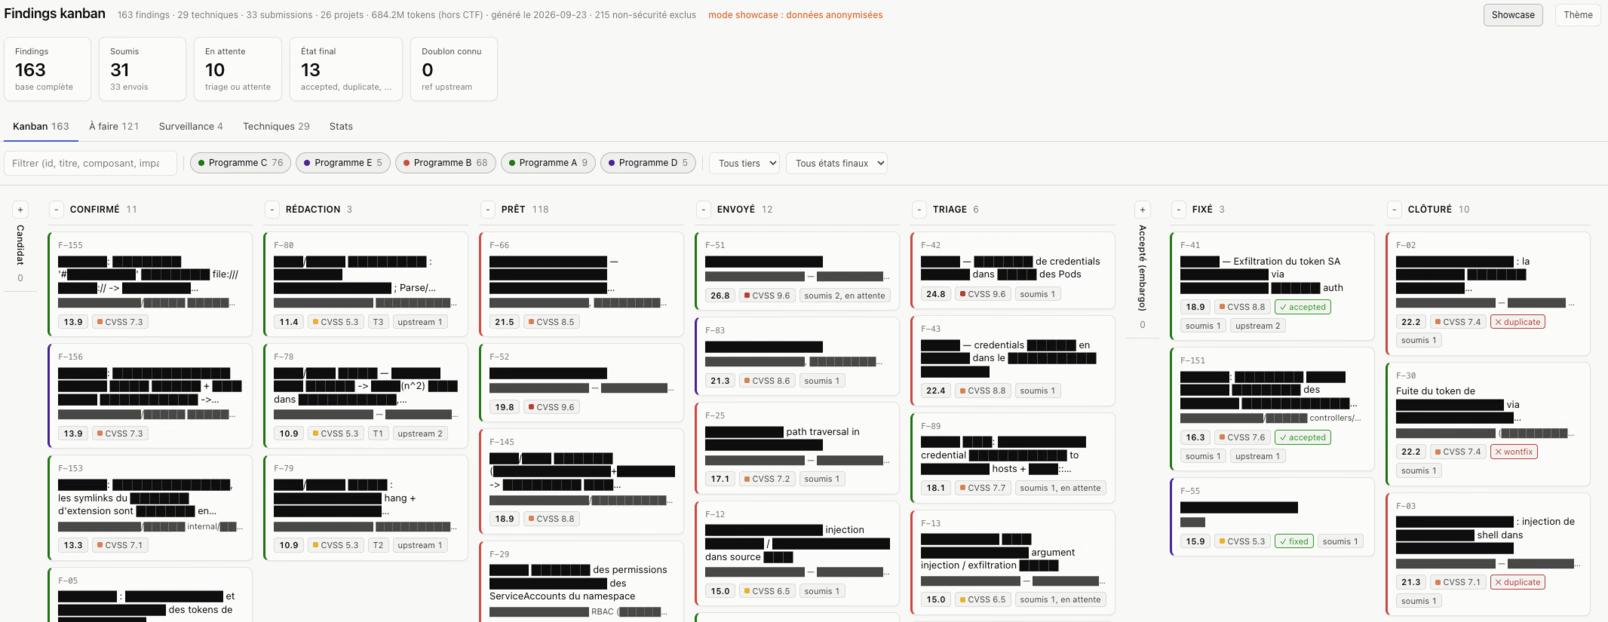
(Les titres ont été censurés pour des raisons évidentes)
Chaque constat est une carte qui progresse de gauche à droite :
- Candidate : signalée par un subagent, pas encore vérifiée
- Confirmée : a survécu à la contre-expertise et à la reproduction
- Rédaction puis Prête : rapport en cours de rédaction, puis prêt à envoyer
- Envoyé et Triage : soumis, en attente que le programme le regarde
- Acceptée (embargo) : acceptée par le programme, correctif ou divulgation en attente
- Corrigée : correctif publié
- Fermée : rejetée comme doublon, wontfix ou informative
Chaque carte porte un score composite (CVSS + risque de wontfix + risque de doublon, on y revient dans la section suivante), le CVSS, combien de fois elle a été soumise, et si elle a déjà été remontée en upstream. Trier par score composite me dit quoi écrire ensuite. Filtrer par programme me dit combien de places il me reste avant d’atteindre la limite de soumission.
La vue stats, c’est aussi un bon retour à la réalité :
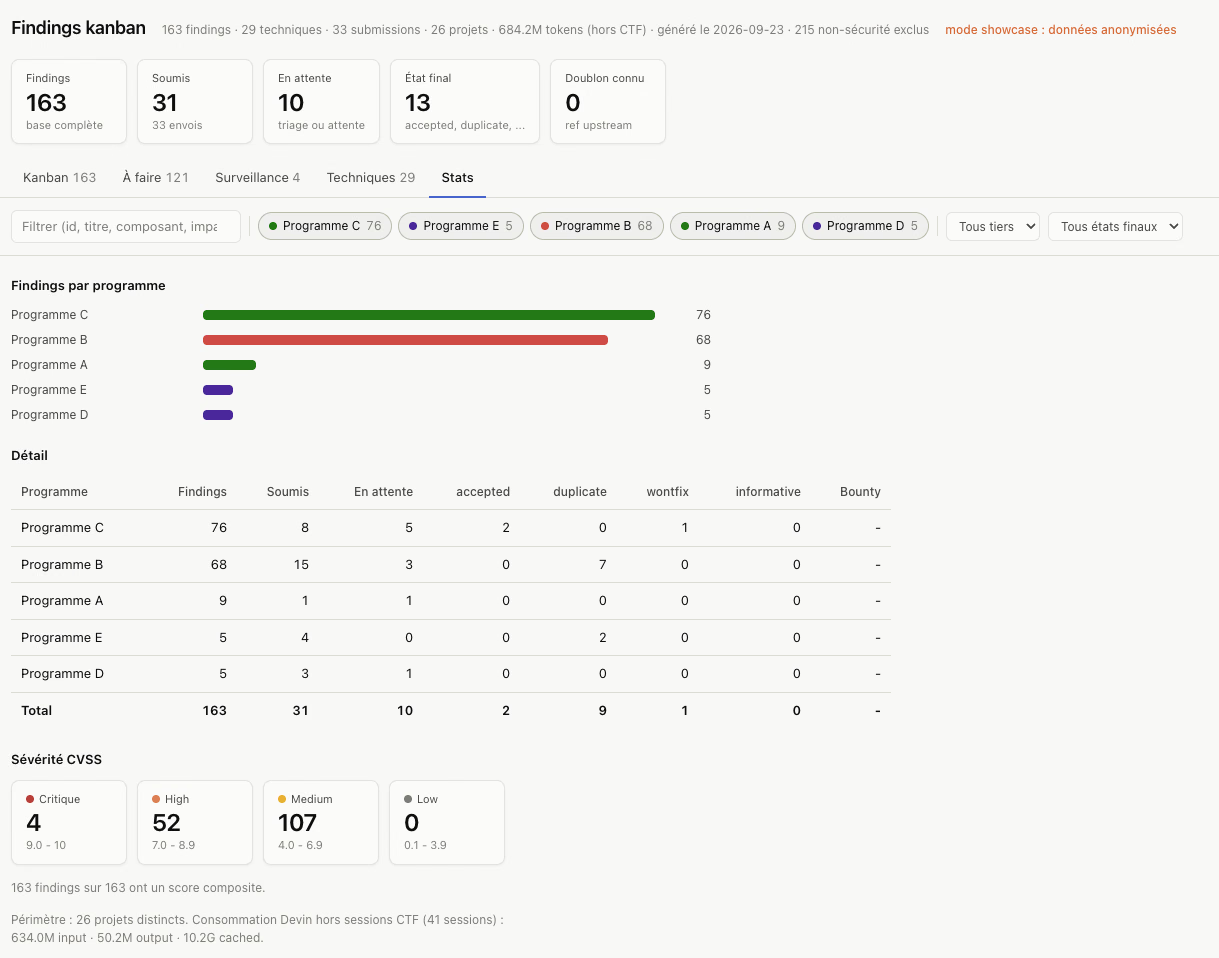
163 constats (après en avoir écarté 215 non-sécurité), sur 26 projets, et seulement 31 soumis.
La seule colonne “Prête” contient déjà 118 constats. En trouver, c’est trivial. Ce qui me limite, ce n’est plus le LLM : c’est mon temps à moi pour reproduire, rédiger et assumer chaque rapport (l’humain dans la boucle est le goulot d’étranglement), puis les plafonds de soumission des programmes. Et même dans ces conditions, être le premier et survivre au triage reste du ressort de la chance.
Quel que soit l’outil que vous utilisez (un tableur fait l’affaire aussi, voire JIRA lol), mettez ça en place avant de commencer à soumettre. Le rajouter après 10 rapports envoyés, en remuant les mails et les boîtes de réception des plateformes, c’est un exercice douloureux.
Vous n’êtes pas seul
Même quand le programme ne verse pas de bounty, attendez-vous à de la concurrence : via les plateformes de bug bounty ou des rapports GHSA (GitHub Security Advisory). Vous pouvez partir du principe que chaque problème “facile à repérer” a été trouvé il y a des mois, plusieurs fois. Sur les projets dont l’équipe sécurité est à bout, comptez plutôt des années.
Je ne peux pas encore donner de détails, mais je suis tombé sur une vulnérabilité qui avait été remontée il y a des années, avec un CVE réservé l’année d’avant, toujours ni corrigée ni publique.
Voilà l’état du triage de sécurité de l’open source aujourd’hui : la file d’attente est plus longue que ce qu’on arrive à traiter, et ça ne s’améliore pas.
Alors si vous visez à être le premier (pour le bounty, pour la gloire), il faut être plus stratégique que la moyenne :
- Évitez les bugs qui se repèrent en lisant un seul fichier, ou qu’un outil SAST/DAST signalerait. Les LLM sont relativement doués pour ça, et vous pouvez être sûr que quelqu’un l’a trouvé avant vous. Malheureusement, c’est peut-être le seul type de constat que vous obtiendrez avec des modèles locaux/petits (ou il vous faut un harness très spécifique).
- Ciblez en priorité du code qui n’est pas le plus audité. Ne visez pas une RCE pré-auth si vous ne savez pas ce que vous faites. Ce code a été audité par des gens bien meilleurs que vous. Visez plutôt du code récent en beta/GA, ou à l’inverse du vieux legacy qui paraît inoffensif.
- Visez des problèmes qui supposent de savoir comment l’outil fonctionne, et ce qui ne devrait pas fonctionner. Les LLM sont mauvais là-dessus : si vous avez cette connaissance, vous avez un avantage.
- Si vous ne payez pas au token, n’hésitez pas à donner le fichier entier au subagent. J’ai découvert par hasard qu’un agent qu’on restreint aux “fonctions sensibles” en rate ÉNORMÉMENT. C’est peut-être moins vrai pour les modèles frontier, mais c’est une vérité absolue pour les modèles moins bons.
De là, j’ai mis au point un score qui évalue mes vulnérabilités non seulement sur leur CVSS, mais aussi sur le risque de “wontfix” de la part des mainteneurs et le risque de “doublon” parce qu’elles étaient trop faciles à trouver.
Conclusion
Est-ce que ça marche ? Oui, absolument. J’ai trouvé des dizaines de vulnérabilités réelles, non corrigées, dans de l’open source en production, allant de sévérité moyenne à critique.
La vérité qui pique : j’ai envoyé plus de 30 rapports jusqu’ici. Sur les verdicts revenus, la plupart étaient des doublons - quelqu’un était arrivé avant moi (mon erreur de débutant : je pensais que les constats faciles passeraient, alors que “facile” signifie simplement que quelqu’un les a déjà trouvés). L’un m’a valu un CVE avec co-crédit, CVE-2026-77524, qui vient de sortir en public : une élévation critique namespace-admin vers cluster-admin dans KEDA ; un autre advisory a été accepté mais n’est pas encore public ; et un correctif a été mergé via une issue publique. Le reste est soit encore en triage, soit bloqué derrière des limites de débit. Certaines plateformes plafonnent les soumissions, par exemple 4 rapports par programme sur une fenêtre glissante de 30 jours, un peu plus si vous chassez sur plusieurs programmes, avec en plus un plafond global sur toute la plateforme.
Et quand un projet ne répond simplement pas ? Je n’ai pas encore de règle parfaite : je relance une fois après quelques semaines. La convention courante, c’est une publication publique après un embargo raisonnable (90 jours), mais je n’ai pas encore décidé si je l’appliquerai. Il y a aussi des paliers intermédiaires, comme escalader auprès d’une CNA, ou de GitHub Security Lab pour les projets hébergés sur GitHub. Un rapport qui pourrit dans une file privée n’aide personne, mais laisser une vulnérabilité non corrigée entre les mains des utilisateurs non plus.
Alors : exploitez cette contrainte. Transformez la faiblesse en atout. Tout le monde se concentre sur les mêmes cibles médiatiques (qui ne veut pas d’une RCE pré-auth ?) ou sur les failles évidentes et faciles. Si vous voulez des résultats (être le premier), laissez tomber les deux. Concentrez-vous sur les cas limites obscurs qui se retrouvent éparpillés sur 3 composants. Oui, ça demande plus de travail, de meilleurs LLM, et un peu de chance.
Si vous commencez maintenant, les victoires faciles sont déjà prises. Mais c’est précisément là que se trouve votre atout : savoir comment devraient se comporter les outils que vous utilisez tous les jours, c’est quelque chose que personne ne peut louer “au token”.