TL;DR
- Suite de l’article de septembre : je concluais que trouver des vulns était devenu trivial et que le goulot d’étranglement, c’était moi, l’humain dans la boucle. Depuis, j’ai industrialisé la partie triage : mon repo d’audit est devenu une usine à findings, avec des agents aux rôles distincts (planification, audit, contre-expertise) et une base qui mémorise toutes les pistes, y compris celles qu’on a écartées.
- Les chiffres qui justifient l’usine : mes rapports n’étaient presque jamais rejetés parce que le bug n’existait pas. Ils échouaient sur des doublons (la moitié des verdicts) ou sur un threat model/impact mal anticipé (informative, wontfix).
- La pièce la plus rentable de l’usine, c’est (toujours) le tri : l’admission et la contre-expertise écartent les mauvaises pistes le plus tôt possible, et la base de claims se souvient de pourquoi elles ont été écartées.
Suite de mon deep dive dans le monde merveilleux du bug hunting
Lors de mon dernier article, j’avais promis un retour rapide et je ne le fais finalement que maintenant.
Pourquoi ? Parce que d’un côté, j’avais beaucoup à dire, mais de l’autre j’ai peu de résultats que je peux annoncer publiquement.
Ça ne veut pas dire que je n’ai pas de résultats (au contraire), juste que je ne peux pas en parler : le triage et la remédiation (en particulier côté programmes “bug bounty”) prennent des mois (au pluriel). Il vous faudra donc me faire confiance et être patients pour les résultats concrets.
Ce que je peux partager, c’est la mécanique. Le pipeline manuel de septembre (un agent principal, des subagents qui relisent, une contre-expertise) tenait avec une centaine de constats. À plus de 2000 pistes, ça ne scale clairement plus.
Surtout, l’analyse des verdicts reçus faisait ressortir un pattern : mes rapports n’échouaient presque jamais parce que le bug n’existait pas. Ils échouaient pour deux raisons :
- doublons : quelqu’un avait trouvé avant, parfois des années avant. C’est la moitié des verdicts, et plus rageant qu’un refus : un doublon, c’est un bug trop simple, trouvé trop tard à l’ère des LLMs ;
- threat model / impact : le bug est réel, mais le programme ne considère pas cette frontière comme de la sécurité, ou l’impact honnête est trop faible (informative, wontfix). Et c’est de loin la première cause si on compte ce que j’écarte moi-même avant soumission.
Commencez par le threat model
Dans le dernier article, j’avais beaucoup insisté sur la “contre-expertise” (demander à un LLM de vérifier le travail d’un LLM, parce que le premier résultat est souvent de la merde) : c’est la partie qui délivre le plus de valeur. Les LLM ont très envie de vous faire plaisir et ont tendance à mal comprendre le fonctionnement des apps qu’ils auditent. On se retrouve avec une quantité de findings hallucinante, dont une très grande partie ne sont pas des failles de sécurité, parfois même pas des bugs du tout.
La contre-expertise limitait déjà beaucoup ce problème, mais pas toujours suffisamment.
Le plus gros changement que je constate dans les projets OSS ces 2 derniers mois, c’est l’ajout de SECURITY.md assez riches et de documents listant explicitement le threat model de l’application, parfois avec des exemples de failles passées acceptées. Je ne sais pas s’ils se sont donné le mot (la vague de rapports IA doit aider à la motivation), mais c’est extrêmement utile quand on automatise le bug hunting. J’ai donc demandé aux agents de constituer, par programme, une fiche avec le threat model du soft, enrichie des failles publiques puis des retours des mainteneurs.
Le plus utile dans cette fiche, ce sont les classes wontfix : une ligne par classe de bug que le projet a déjà refusée, toujours sourcée (verdict d’un mainteneur, issue). Exemple réel : ESO (External Secrets Operator) a déjà classé unmanaged write/delete en wontfix. Tout ce qui y ressemble est donc écarté d’emblée, et plus personne n’investit de repro dessus. Quand une contre-expertise fait émerger une nouvelle classe, c’est moi qui la valide la première fois ; ensuite, elle devient un filtre automatique.
Sur certains programmes, les mainteneurs ont une vision très large du threat model et acceptent à peu près tout ce qui ressemble à une faille, pour peu qu’on ait un PoC solide. J’étais déjà assez bon sur cette partie. Pour d’autres en revanche, il n’y a quasiment rien dans le threat model, notamment certains opérateurs Kubernetes qui excluent toutes les CRD (alors que leur chart les agrège par défaut à edit, lol). Dans ces conditions, tout ce qui est un détournement de la CR (type SSRF ou confused deputy) n’est pas considéré comme une faille.
Je ne suis pas d’accord avec cette philosophie, surtout quand elle n’est pas documentée, mais ce n’est pas à moi d’en décider. En revanche, une fois posé noir sur blanc, le threat model évite à tout le monde de perdre du temps, à moi comme aux mainteneurs. C’est ce qui transforme mes wontfix passés en actif : ce ne sont plus seulement des échecs, ce sont mes futures règles de triage.
L’usine logicielle
Au-delà du threat model, le plus gros changement sur mon harness, c’est l’automatisation.
Si vous suivez d’un œil distrait les trends sur l’IA dans le dev, vous avez forcément entendu le terme “““d’usine logicielle””” depuis plusieurs mois. En gros : un graphe orienté d’agents qui prennent une tâche en entrée (un ticket, voire une idée brute qu’ils découpent eux-mêmes), font leur truc (dev, QA, mise en prod, correction…) et passent le relais au suivant selon le résultat.
De mon côté, mon workflow d’il y a 2 mois était hyper simple :
- je promptais pour auditer de manière plus ou moins maligne un soft ou une partie d’un soft, avec un angle, une technique… => des candidats ;
- je demandais ensuite au LLM de regarder les candidats, de valider le code, de faire un test (idéalement une repro E2E) => élimine une partie des candidats, valide le reste ;
- je demandais ensuite une contre-expertise des findings “validés” => une partie éliminée (par ex. un claim “dominé”, qui ne donne rien de plus que ce que ses préconditions permettent déjà), renvoyée à l’étape d’avant pour des tests complémentaires, ou définitivement validée, avec ou sans réserve.
Assez simple pour que j’aie d’abord eu la flemme d’automatiser. Mais quand on multiplie les programmes, chaque relance manuelle oubliée, c’est un finding qui pourrit dans un coin. Voici donc la version actuelle :
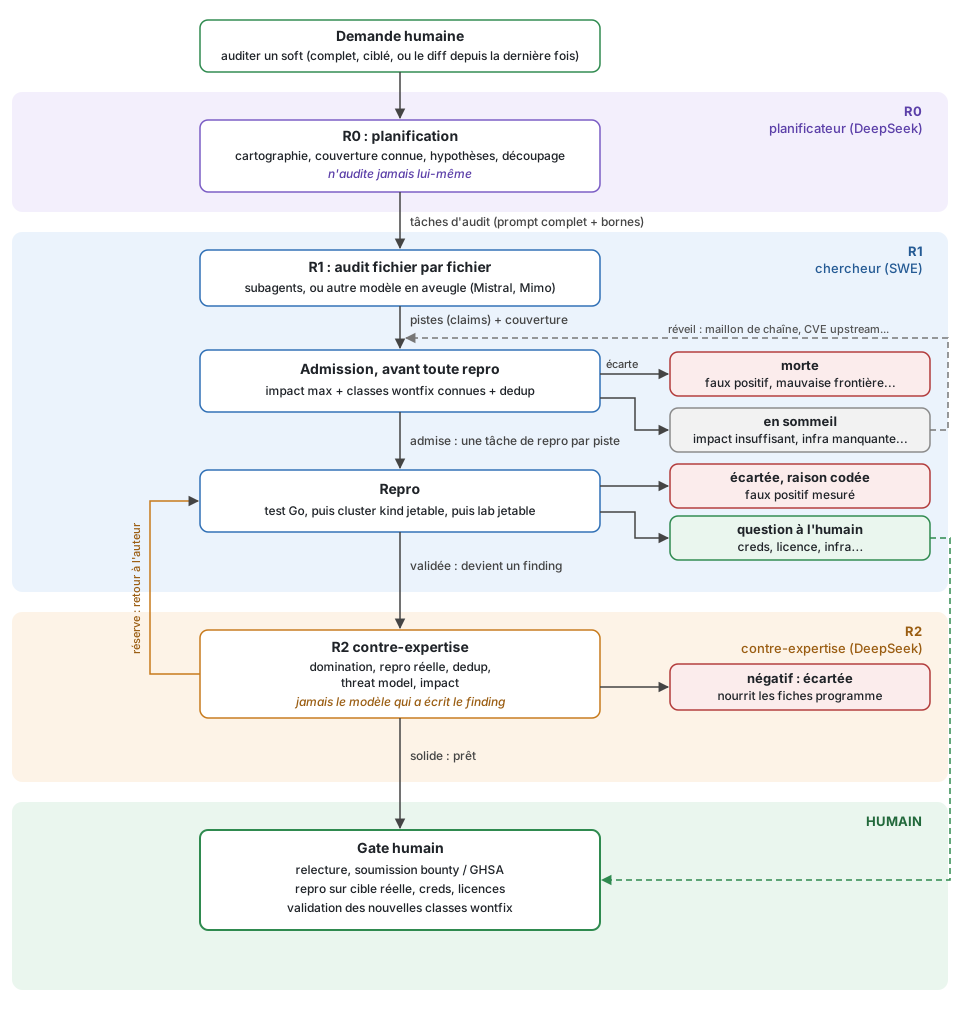
J’aurais pu mettre en place une usine complexe avec des outils du marché (tout le monde réinvente la roue à sa sauce), mais dans mon cas, quelques scripts Python et un peu de JSON suffisent largement, pour l’instant. Une file de tâches, un agent par rôle, et un hook qui, au lieu de laisser l’agent s’arrêter en fin de tour, lui injecte la tâche suivante. Chaque étape terminée enfile automatiquement la suivante (audit, admission, repro, contre-expertise, retour à l’auteur en cas de réserve) : l’agent n’a plus à “penser” à enfiler la suite, elle existe by-design.
Ce workflow m’a fait gagner énormément de temps. Je lance la machine sur un soft et une méthode, et j’attends. Je n’ai plus qu’à lire les rapports “prêts”, à les comprendre, à les réessayer moi-même si je ne comprends pas, et à les soumettre quand je les comprends et que j’estime qu’ils sont assez solides pour ne pas passer pour un guignol.
La base de claims : le cœur de l’usine
La vraie nouveauté par rapport à septembre, ce ne sont pas les rôles, c’est la base de claims (un peu plus de 2000 entrées aujourd’hui). Son principe : tout ce que les audits remontent est un claim (une piste), pas seulement ce qui finit en finding.
Quelques choix qui comptent :
- On n’écarte pas une piste sans raison codée (faux positif, mauvaise frontière, doublon, impact insuffisant…), et c’est la raison qui décide si la piste est morte ou seulement en sommeil. Un claim à faible impact n’est pas mort : il peut devenir le maillon d’une chaîne plus tard, et il se réveille si un “partenaire” apparaît.
- On garde l’historique : chaque tentative est conservée, et un agent qui reprend une piste bloquée sait où son prédécesseur s’est arrêté.
- On sait ce qui a déjà été regardé : chaque audit enregistre ce qu’il a couvert, à quel commit. Plus de re-audit inutile, et le mode
reauditpeut se concentrer sur le diff depuis le dernier passage. - Le dedup est obligatoire avant promotion : la leçon du mois dernier, c’est un agent qui voulait me faire report une “nouvelle” faille sur Talos alors que je l’avais déjà signalée par un autre vecteur, et qu’elle était de toute façon déjà corrigée (c’était ma GHSA TimeCheck).
Ce qui reste humain, délibérément
L’agent décide seul de l’admission, des repros sur cible jetable (kind, lab Talos, tests Go) et de l’élimination des pistes. Je garde :
- toute repro sur une cible réelle : typiquement le service managé d’un programme bounty (un cloud, un SaaS), qu’on teste en production avec un vrai compte. Là, une fausse manip n’est plus sans conséquence ;
- toute soumission : je gère mes envois seul, je lis et j’assume chaque rapport ;
- la première validation d’une nouvelle classe wontfix : une fois validée, elle écarte automatiquement toutes les pistes qui lui ressemblent, donc une classe mal comprise tuerait en silence de vraies failles ;
- les questions : dans le doute, l’agent “parque” sa tâche et pose la question au lieu de deviner. Au moment où j’écris, quatre tâches attendent ainsi un credential cloud, une licence Entreprise +++ ou l’activation d’une feature flag ;
- même une redirection de repo GitHub vers une org que je n’ai pas autorisée : décider qu’une redirection vaut autorisation, ce n’est pas le rôle d’un agent.
Tout ce qui attend une action de ma part est regroupé dans une vue dédiée de mon kanban, devenue mon point d’entrée quotidien.
Amélioration de la recherche
Quelques enseignements en vrac, côté génération :
- Adaptez les patterns au code que vous attaquez. On ne cherche pas une XSS dans un opérateur Kubernetes. Plutôt que de balayer bêtement tous les fichiers, le planificateur produit des hypothèses (parser differentials, races, logique authz, chaînes entre composants…) guidées par le threat model et les refus passés du programme, et l’auditeur les vérifie une par une. Sur un repo déjà “labouré”, ça évite de retrouver les mêmes doublons évidents.
- Déléguez la contre-expertise à un autre modèle. Ça tombe bien : mon abonnement Devin donne SWE en illimité (sans quota), je peux donc consacrer le quota “autres modèles” à la contre-expertise : DeepSeek 4.1 flash en mode high suffit largement et ça crame très peu de quota. Et c’est imposé par le code, pas par une consigne qu’un agent pourrait oublier : un finding ne peut pas passer “prêt” s’il a été contre-expertisé par le modèle qui l’a écrit.
- Testez d’autres modèles pour la diversité. J’ai essayé Mistral 4 et Mimo 2.6, avec des résultats corrects. Mistral 4 m’a coûté une trentaine de dollars de tokens pour un audit complet de Talos Linux, sans apporter grand-chose de plus que SWE : aucun de ses 8 findings n’a passé la contre-expertise. Intéressant “pour la science”, mais pas un game changer.
- Les LLM sont non déterministes : exploitez-le. Deux runs identiques ne trouvent pas les mêmes claims. J’ai testé en aveugle sur Talos : 4 audits indépendants, même commit, même prompt. Chaque run a raté des failles que les autres avaient trouvées, et ma GHSA TimeCheck n’a été retrouvée par aucun des 4. 2 ou 3 runs fusionnés semblent un bon compromis : c’est une façon de trouver plus de failles sans changer de modèle (mais ça coûte cher si vous payez au token).
Les chiffres à date (honnêtes)
Je donne des ordres de grandeur, le chiffre exact change tous les jours et n’a pas grand intérêt.
- Admission : sur le millier de claims passés par l’admission, environ 70 % ont été tués d’emblée et moins de 10 % ont fini en finding. C’est le chiffre clé : 7 pistes sur 10 sont écartées avant même de tenter une repro.
- Environ 800 tâches traitées par la file depuis sa création.
- Près de 700 findings dans la base (dont une partie date d’avant l’usine). Ne regarder que la quarantaine de rapports “prêts” cacherait l’essentiel :
- plus de 500 ont été écartés en interne sans jamais être soumis (impact trop faible, wontfix anticipé, doublon, repro négative…) : c’est l’échec pas cher ;
- une soixantaine attendent quelque chose de moi (relecture, creds, infra) ;
- 80 environ ont été soumis. Sur ceux qui ont reçu un verdict, la moitié sont des doublons, un quart sont des acceptés, et le reste des informative/wontfix. Presque la moitié des soumissions attendent encore un verdict.
- Parmi les raisons d’élimination des pistes, doublons et mauvaise frontière sont dans le top : ça confirme le diagnostic initial, c’est bien le triage, pas la génération, qui coûtait.
Ce que l’usine n’a PAS changé : elle ne trouve pas de meilleures vulns. La qualité des findings vient toujours des méthodes de sweep et de la contre-expertise.
Et côté complexité et originalité des findings (et donc leurs chances de ne pas être un doublon), j’ai l’impression d’atteindre un plafond, comme à l’époque où je cherchais avec le Qwen 3.6 d’OVHcloud.
Mon harness trie mieux et enchaîne plus vite, mais il ne rend pas les modèles plus intelligents. Et soyons honnêtes : je ne joue pas du tout à armes égales avec ceux qui ont un abonnement aux frontier models, et surtout la validation qui permet de les utiliser pour des tâches cyber.
Conclusion
L’article de septembre disait : “être le premier et survivre au triage, c’est ça le métier”. L’usine est la réponse mécanique à ça, parce que survivre au triage se prépare en amont : dedup tôt, threat model tôt, élimination pas chère tôt. Le LLM trouve ; la chaîne trie ; moi, je reproduis, je rédige et j’assume.
Si je ne devais retenir que deux leçons de ces derniers mois :
- la critique croisée doit être imposée par la mécanique, pas demandée gentiment : on ne demande pas à un modèle de se critiquer lui-même, la contre-expertise tourne sur un autre modèle ;
- la passe de main est le bug classique des pipelines d’agents : mes vrais trous en prod étaient tous des transitions qui n’existaient pas (une admission sans repro derrière, une réserve de contre-expertise sans retour à l’auteur). Si votre pipeline repose sur “l’agent pensera à enfiler la suite”, il a des trous.
Et comme la dernière fois, la question “est-ce que ça marche” a une réponse mesurable, mais encore partielle : les GHSA déjà publiques datent du pipeline manuel de septembre, et la première faille acceptée qui sort entièrement de l’usine (écrite par un modèle, contre-expertisée par un autre) est corrigée mais encore sous embargo ; patience, ça vient. L’usine ne rend pas plus malin. Elle rend plus régulier, et en bug bounty, la régularité paie sur la durée.